Willow visar vägen mot kvantdatorn som kan rätta sina egna fel
Googles genombrott handlar inte främst om hastighet – utan om att fler kvantbitar för första gången på denna plattform pålitligt kan ge färre fel.
Kvantdatorns största fiende finns inne i själva maskinen: små störningar som förstör den ömtåliga kvantinformationen. Med Willow har Google visat att felkorrigeringen kan bli bättre när den byggs ut. Men mellan ett uppmärksammat experiment och en användbar kvantdator återstår ett omfattande ingenjörsarbete. IBM och svenska WACQT angriper samma grundproblem från delvis olika håll.
Uppläst av tidningens berättarröst
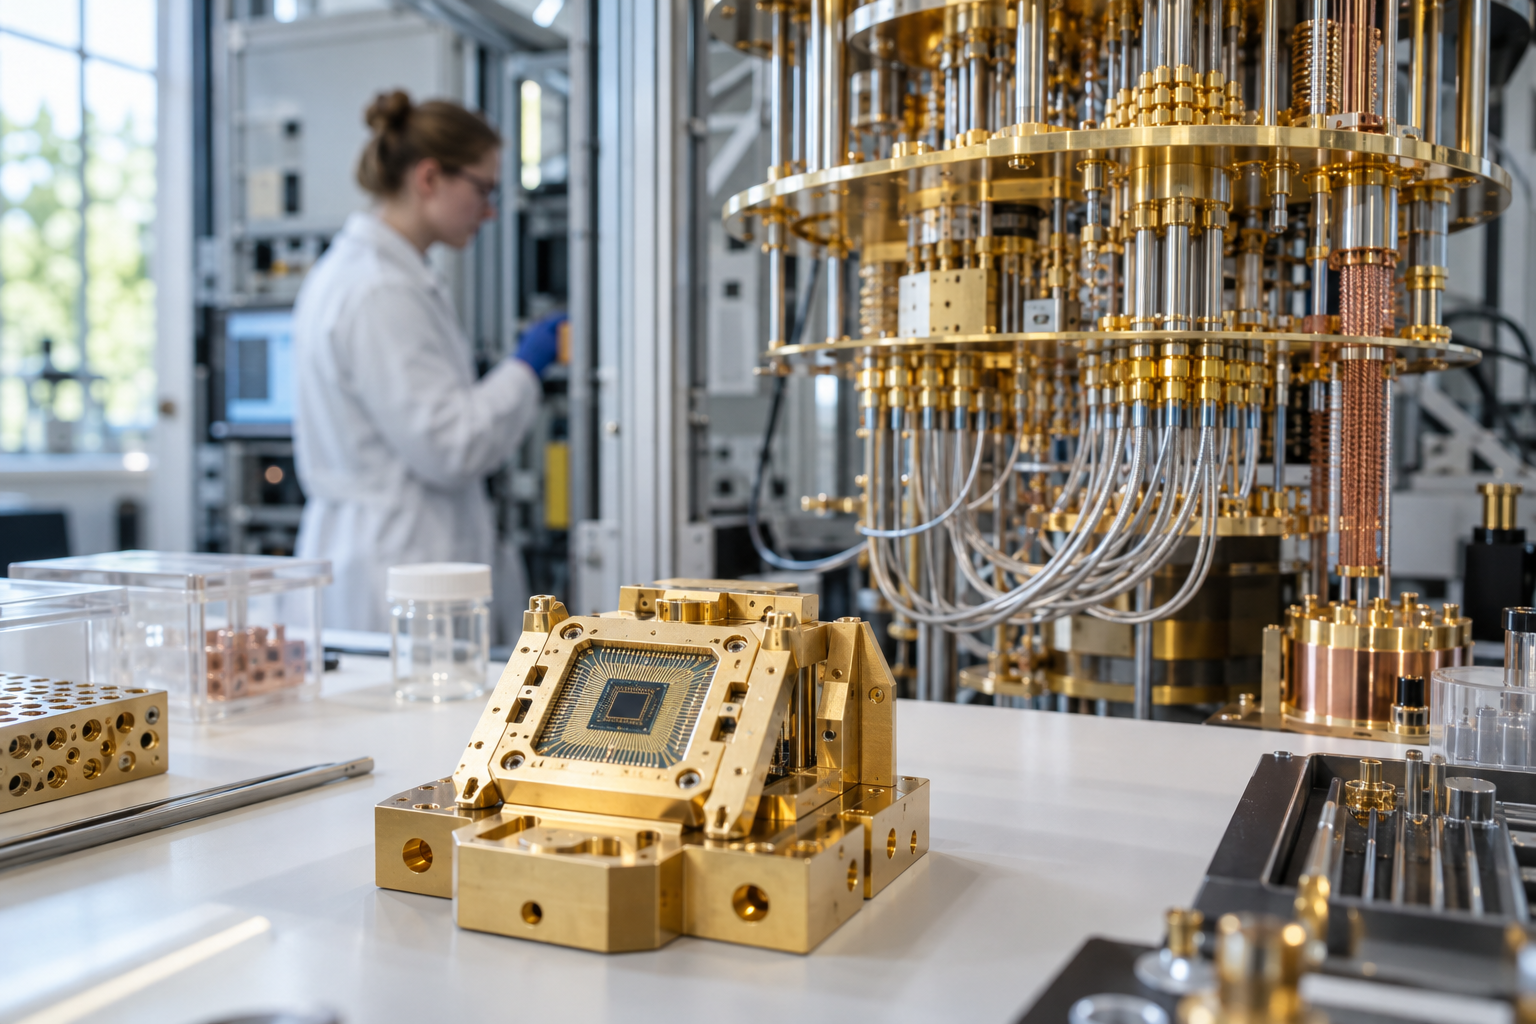
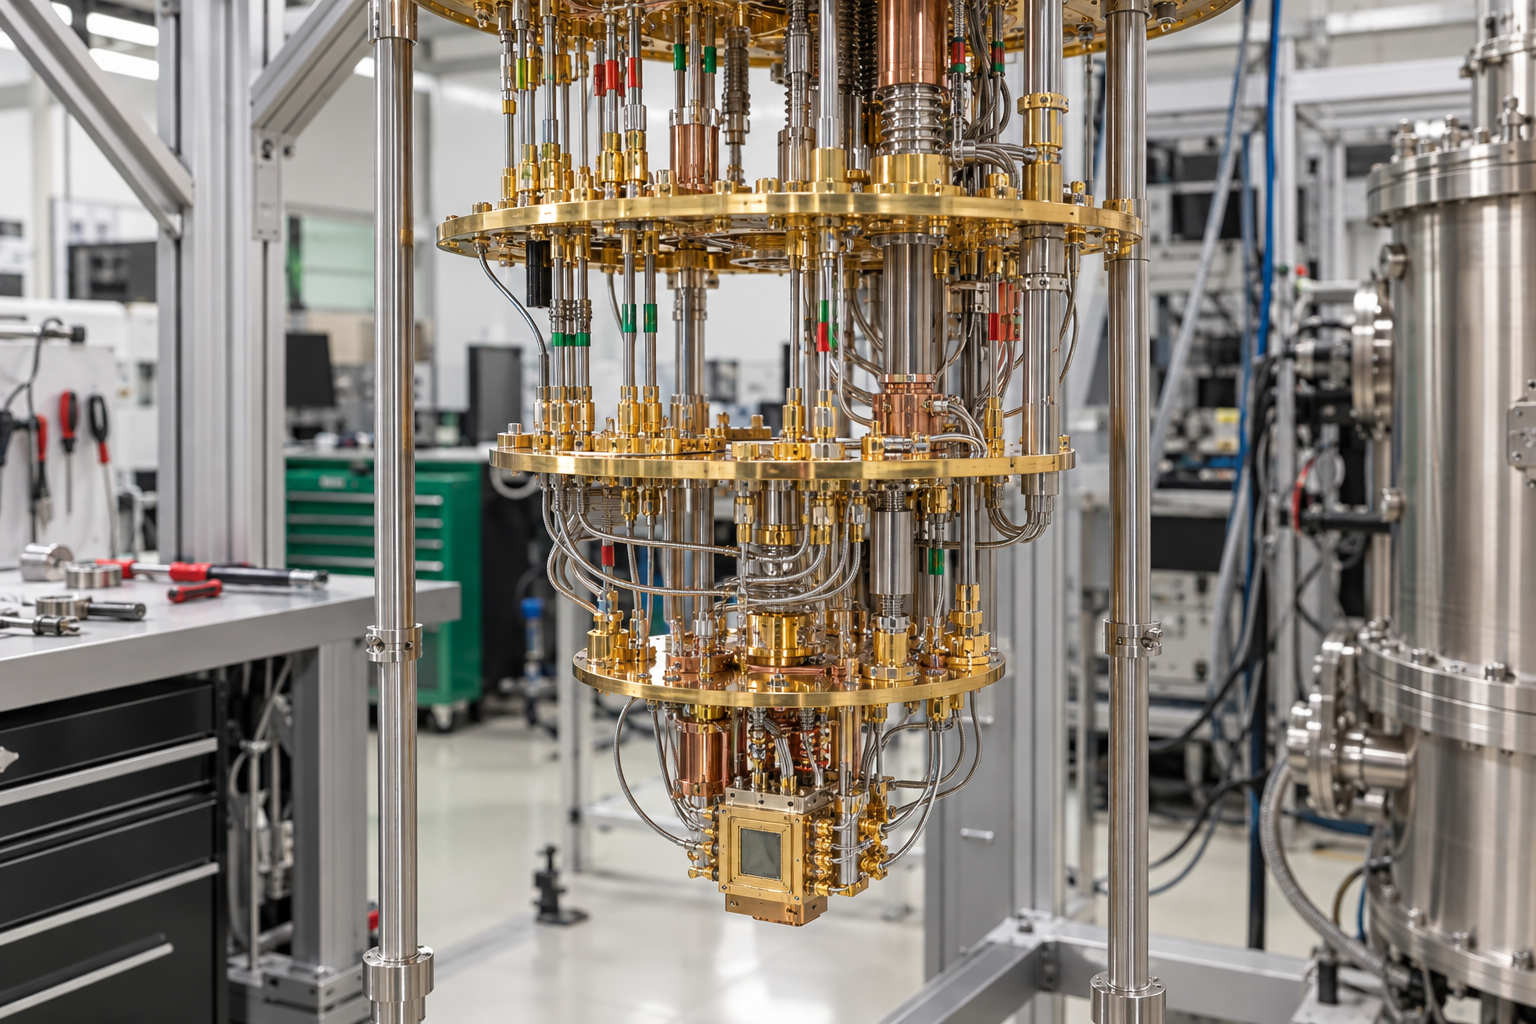
På bilden ser det ut som ett litet, fyrkantigt chip. I laboratoriet kräver det en betydligt större omgivning: ett kylsystem med flera temperatursteg, kablar för mikrovågspulser och elektronik som måste styra och avläsa kvantbitar med mycket hög precision. Längst ned i kylsystemet, vid temperaturer på några tiotal tusendels grader över den absoluta nollpunkten, arbetar de supraledande kretsarna.
Det är här Googles processor Willow ska göra något som låter motsägelsefullt: använda fler felbenägna komponenter för att skapa en mindre felbenägen beräkning.
När Google presenterade Willow i december 2024 hamnade en annan uppgift snabbt i rubrikerna. En särskild testberäkning hade enligt företaget tagit under fem minuter. Google uppskattade att motsvarande uppgift skulle kräva omkring 10²⁵ år på en av världens snabbaste klassiska superdatorer. Siffran är svindlande, men den bygger på antaganden om hur en klassisk dator skulle lösa just detta test.
Den mer avgörande nyheten fanns i en artikel i Nature. Där visade forskarna att de kunde minska felfrekvensen hos en skyddad, logisk kvantbit genom att låta fler fysiska kvantbitar samarbeta. Maskinen befann sig under den feltröskel där kvantfelkorrigering börjar löna sig när den skalas upp.
Det är inte samma sak som att en praktiskt användbar, feltolerant kvantdator är färdig. Men det är ett svar på en fråga som har följt området i årtionden: går det att bygga större utan att samtidigt bygga sönder kvantinformationen?
Det ömtåliga som måste överleva
En vanlig dator arbetar med bitar som representerar noll eller ett. En kvantbit kan dessutom beskrivas av en superposition av dessa tillstånd. Flera kvantbitar kan vara sammanflätade, så att deras gemensamma tillstånd inte kan reduceras till separata beskrivningar av varje del.
Den populära bilden av en kvantdator som provar alla svar samtidigt är därför missvisande. Det räcker inte att skapa många möjliga beräkningsvägar. En kvantalgoritm måste styra deras interferens så att sannolikheten för användbara svar förstärks och andra bidrag motverkar varandra. När systemet till sist mäts får man ett vanligt, klassiskt resultat.
För att detta ska fungera måste de relativa faserna i kvanttillståndet bevaras. En liten, oönskad växelverkan med omgivningen kan förändra dem. Energi kan läcka ur en kvantbit, styrpulser kan vara aningen felkalibrerade och en avläsning kan ge fel besked. Även kopplingar mellan närliggande komponenter kan skapa störningar.
I en supraledande processor byggs kvantbitarna av elektriska kretsar med bland annat Josephsonövergångar. De beter sig under rätt förhållanden som kontrollerbara kvantmekaniska system. Mikrovågspulser används för att utföra operationer, och särskilda resonatorer hjälper till att läsa av tillstånden.
Det extremt kalla kylsystemet dämpar termiska störningar men avskaffar inte alla fel. Materialdefekter, oönskade elektromagnetiska signaler och variationer i själva styrningen finns fortfarande kvar. Dessutom måste informationen hanteras snabbt nog: även när ingen avsiktlig operation utförs fortsätter kvanttillståndet att påverkas av sin omgivning.
Därför är antalet kvantbitar ett ofullständigt mått på en processors kapacitet. En stor processor med bristfälliga operationer kan vara mindre användbar än en mindre med bättre kontroll. Det viktiga är hur många operationer en beräkning kan genomföra innan felen gör resultatet opålitligt.
Det är särskilt tydligt för de användningar som driver en stor del av forskningen. Att noggrant simulera elektroner i en komplicerad molekyl kan kräva långa sekvenser av operationer. Ett litet fel i varje steg blir då ett stort problem tillsammans. Den tänkta nyttan ligger inte bara i att skapa ett avancerat kvanttillstånd, utan i att hålla en hel beräkning på rätt spår.
Att upptäcka fel utan att läsa svaret
I klassisk informationsteknik är redundans ett välkänt skydd. Man kan lagra extra kontrollbitar eller skicka ett meddelande med ett mönster som gör fel möjliga att upptäcka. Den enklaste intuitionen är att skriva samma bit flera gånger och låta majoriteten avgöra.
Kvantinformation tillåter inte en direkt kopia av den metoden. Ett okänt kvanttillstånd kan inte kopieras godtyckligt. Om man i stället mäter varje kvantbit direkt riskerar man att förstöra den superposition som beräkningen behöver.
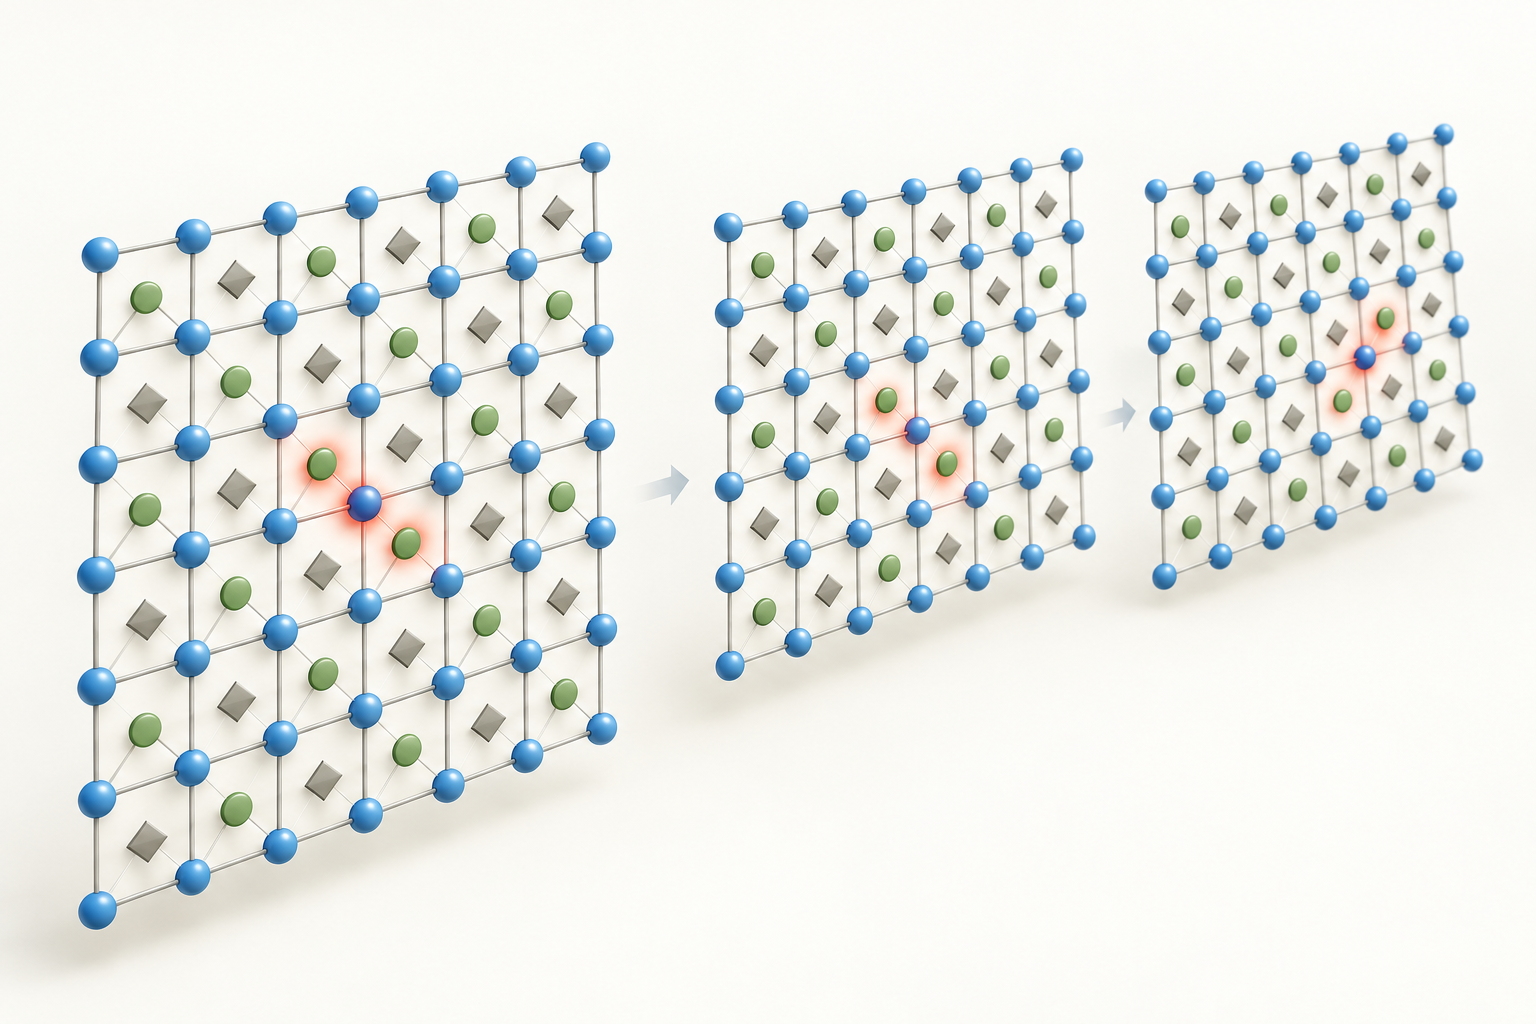
Kvantfelkorrigering tar därför en omväg. Informationen kodas i ett gemensamt tillstånd hos många fysiska kvantbitar. Extra mätningar avslöjar vissa relationer mellan dem, utan att avslöja själva den logiska informationen. En sådan mätning kan liknas vid att kontrollera om två delar följer samma regel, i stället för att fråga vilket värde varje del har.
Resultaten kallas felsyndrom. Ordet kommer från samma grundidé som inom diagnostik: ett mönster av tecken används för att sluta sig till vad som har gått fel. Eftersom också syndrommätningarna kan vara felaktiga måste de upprepas. Avkodningsprogrammet behöver följa hur mönstret förändras över tiden.
Willow-experimentet använde en ytkod, på engelska surface code. Där organiseras kvantbitar i en tvådimensionell struktur med lokala kopplingar. Vissa bär den kodade informationen, medan andra används för kontrollmätningar. Konstruktionen passar relativt väl för supraledande chip, där kopplingar mellan grannar är enklare att realisera än godtyckliga förbindelser över hela processorn.
En klassisk dator tar hand om mätströmmen och bedömer vilka fel som sannolikt har inträffat. Ofta behöver hårdvaran inte omedelbart utföra en fysisk motoperation. Systemet kan i stället hålla bokföring över en korrigering och tolka senare operationer och avläsningar utifrån den.
Det låter enkelt i princip. I praktiken ska kvantchip, mätelektronik och avkodare arbeta som ett sammanhängande system. För långsam avkodning kan skapa en kö av obesvarade felmeddelanden. Missade korrelationer kan leda till fel slutsats. Felkorrigeringen är därför lika mycket en fråga om klassisk databehandling och styrteknik som om kvantfysik.
Den avgörande frågan är inte om varje komponent är perfekt, utan om helheten kan skydda informationen trots att komponenterna är ofullkomliga.
En logisk kvantbit är alltså inte en ny sorts fysisk komponent. Det är en funktion som uppstår när många komponenter, mätningar och beräkningar samarbetar. Skillnaden liknar den mellan en enskild osäker uppgift och ett välkontrollerat system som kan upptäcka när något blivit fel.
Vad Willow faktiskt visade
Willow har 105 fysiska kvantbitar. I Nature-arbetet använde Google olika stora ytkoder för att undersöka hur skyddet förändrades när kodningen byggdes ut. Den centrala jämförelsen gällde kodavstånden tre, fem och sju.
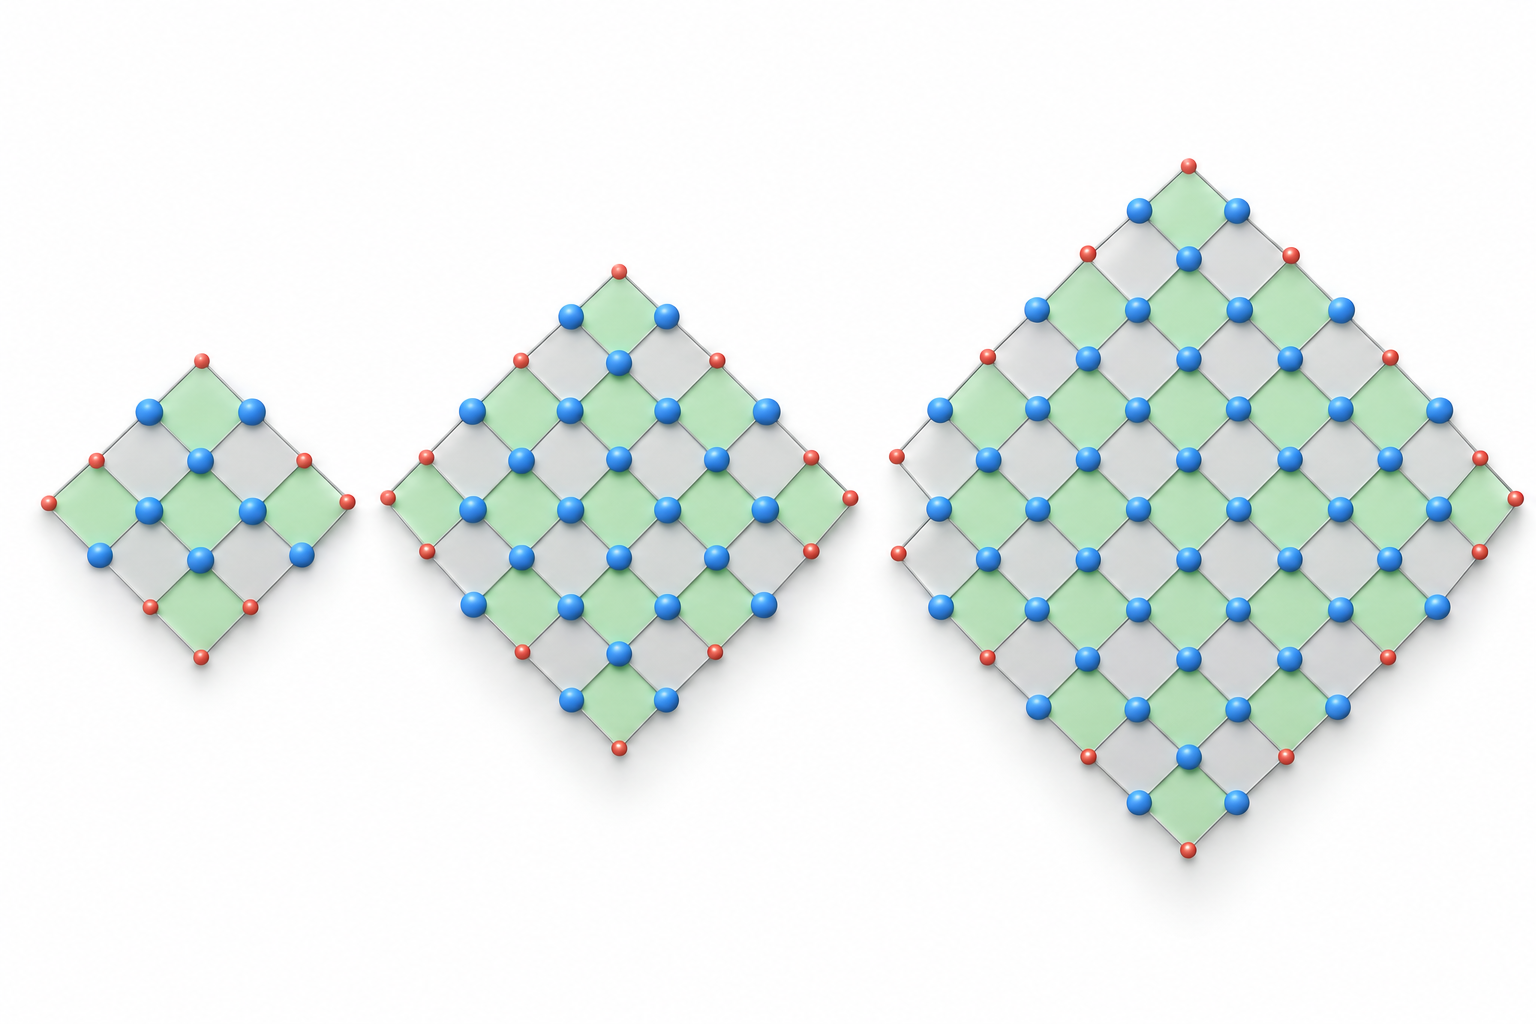
Kodavståndet är ett tekniskt mått på skyddets styrka: förenklat anger det hur omfattande ett felmönster minst måste vara för att kunna ändra den logiska informationen utan att avslöjas på det sätt koden är avsedd att upptäcka. Ett större avstånd ger möjlighet att hantera fler fel, men kräver också fler kvantbitar och fler operationer.
Där finns själva tröskelproblemet. Om varje extra kontrolloperation tillför för mycket brus kan en större kod göra situationen sämre. Under rätt feltröskel blir det tvärtom. Den ökade förmågan att upptäcka och hantera fel väger då tyngre än de nya felkällor som tillkommer.
Forskarna rapporterade att den logiska felfrekvensen minskade med en faktor på ungefär 2,14 när kodavståndet ökades med två steg i den undersökta serien. För minnet med kodavstånd sju var den logiska felfrekvensen omkring 0,143 procent per felkorrigeringscykel. Den största kodningen använde 101 av processorns kvantbitar.
Det väsentliga är inte bara en låg siffra i ett enstaka test, utan riktningen: ett större skydd gav systematiskt bättre resultat. En tidigare svårighet hade varit att vinsten med större koder var liten eller riskerade att ätas upp av hårdvarans fel.
Resultatet ska samtidigt läsas med rätt begränsningar. Det gällde ett kvantminne under upprepade felkorrigeringscykler, inte en fullständig, godtycklig algoritm som kördes på många logiska kvantbitar. Att bevara information är en nödvändig byggsten. Att bearbeta den med ett komplett bibliotek av tillförlitliga logiska operationer är nästa nivå.
Inte heller är tröskeln ett enda universellt procenttal. Den beror på kod, avkodare, kopplingar och felens karaktär. Oberoende småfel är enklare att hantera än störningar som samtidigt påverkar många kvantbitar. Ett system som fungerar väl under vanliga förhållanden kan dessutom utsättas för ovanliga händelser som blir avgörande under mycket långa körningar.
När Google talar om en exponentiell förbättring av felkorrigeringen syftar det på hur felet kan minska när kodavståndet ökar. Experimentet stödjer denna utveckling över de storlekar som prövades. Det innebär inte att varje framtida utbyggnad automatiskt kommer att följa samma kurva. Den måste fortsätta verifieras när processorerna blir större och mer komplexa.
Fem minuter, 10²⁵ år – och två olika genombrott
Hartmut Neven, som grundade och leder Google Quantum AI, presenterade Willow som ett viktigt steg mot användbara, storskaliga kvantdatorer. I företagets kommunikation låg två resultat tätt tillsammans: felkorrigeringen och den extrema tidsjämförelsen med klassiska superdatorer.
De besvarar emellertid olika frågor.
Hastighetstestet byggde på random circuit sampling, ungefär provtagning från slumpmässiga kvantkretsar. Kvantprocessorn utför ett bestämt mönster av operationer och producerar bitsträngar med en sannolikhetsfördelning som bestäms av kretsen. Uppgiften för en klassisk dator är att efterlikna denna provtagning med angivna krav på kvalitet.
Detta är ett användbart sätt att pressa en kvantprocessors kapacitet och undersöka när klassisk simulering blir svår. Men resultatet är inte ett läkemedelsförslag, en materialegenskap eller svaret på ett vardagligt optimeringsproblem. Testet är valt just för att utnyttja kvantmaskinens arbetssätt och vara svårt för klassiska metoder.
Googles uppskattning på omkring 10²⁵ år är därför inte en uppmätt väntetid. Den är en beräkning utifrån antaganden om klassiska algoritmer, tillgängliga resurser och hur simuleringen ska genomföras. Sådana uppskattningar kan förändras när nya klassiska metoder utvecklas. Historien efter tidigare demonstrationer av kvantfördel visar att den klassiska konkurrensen inte står stilla.
Det gör inte experimentet ointressant. En processor som kan skapa och kontrollera kvanttillstånd bortom bekväm klassisk simulering är ett viktigt vetenskapligt instrument. Men det motiverar inte påståendet att samma chip skulle vara motsvarande mycket snabbare på alla beräkningar.
De fem minuterna var inte heller en demonstration av en stor, felkorrigerad tillämpningsalgoritm. Att blanda ihop de två resultaten skapar en alltför kort väg från laboratoriet till praktisk nytta. Felkorrigeringstestet handlar om tillförlitlighet; provtagningstestet handlar om en särskild beräkningsuppgifts svårighet för klassiska datorer.
Även talet om parallella universum, som Neven tog upp i samband med resultatet, bör hållas åtskilt från den experimentella slutsatsen. Kvantdatorns beteende kräver kvantmekanik för att beskrivas, men testet avgör inte vilken tolkning av kvantmekaniken som är riktig. Det är hårdvarans och beräkningens egenskaper som har prövats, inte existensen av andra universum.
IBM och den dyra vägen till logiska operationer
Googles arbete ingår i en bredare kapplöpning där olika grupper prioriterar olika delar av problemet. IBM har byggt stora supraledande processorer och gjort kvantsystem tillgängliga via molnet. Företaget arbetar både med dagens brusiga maskiner och med arkitekturer för framtida felkorrigering.
En central skillnad är den mellan felmitigering och felkorrigering. Felmitigering försöker uppskatta ett bättre svar genom extra mätningar, modellering av brus eller jämförelser mellan körningar med olika störningsnivåer. Informationen skyddas då inte fortlöpande på det sätt som en felkorrigerande kod är avsedd att göra.
IBM visade 2023 ett uppmärksammat experiment med 127 kvantbitar, där felmitigering användes för att beräkna egenskaper hos ett kvantfysikaliskt modellsystem. Arbetet undersökte möjligheten till användbarhet innan full feltolerans uppnåtts. Efter publiceringen utvecklade andra forskare klassiska metoder som klarade relevanta delar av jämförelsen bättre än tidigare. Det illustrerar hur både kvantmetoder och deras klassiska motståndare måste granskas löpande.
För större, längre beräkningar blir den övergripande frågan ändå hur logiska kvantbitar ska byggas med rimliga resurser. Ytkoden är attraktiv eftersom den kräver relativt lokala kopplingar, men den kan bli kostsam i antal fysiska kvantbitar.
IBM-forskare har därför bland annat studerat så kallade kvant-LDPC-koder, där LDPC står för low-density parity-check. Sådana koder kan under vissa förutsättningar skydda flera logiska kvantbitar med mindre redundans. Vinsten kommer dock med andra krav, exempelvis på vilka kvantbitar som måste kunna kopplas samman. En elegant kod på papperet är inte automatiskt enkel att bygga i ett chip.
Det finns alltså ingen enda skala där flest kvantbitar alltid betyder störst framsteg. En arkitektur kan behöva fler komponenter men enklare ledningsdragning. En annan kan spara kvantbitar men kräva mer komplicerade förbindelser eller kontrollsekvenser.
Därtill kommer logiska operationer som är betydligt mer krävande än att bara lagra ett tillstånd. Många feltoleranta beräkningsmodeller behöver särskilda hjälptillstånd för vissa operationer. Att framställa dem med tillräcklig kvalitet kan kräva stora resurser, ibland beskrivna som särskilda fabriker inne i kvantdatorns arkitektur.
Frågan ”hur många kvantbitar behövs?” har därför inget fristående svar. Den måste följas av: för vilken algoritm, med vilket tillåtet fel, på vilken hårdvara och med vilken kod? En enda logisk kvantbit i ett minnesexperiment och en logisk kvantbit som deltar i en lång tillämpning ställer inte samma krav på resten av systemet.
I Göteborg byggs kompetensen runt kvantbiten
Den svenska kopplingen finns bland annat på Chalmers, där Wallenberg Centre for Quantum Technology, WACQT, leds. Satsningen startade 2018 med stöd från Knut och Alice Wallenbergs Stiftelse och omfattar flera svenska lärosäten. Den rymmer kvantberäkning, kvantkommunikation, kvantsimulering och kvantsensorer.
Ett centralt projekt är att bygga en svensk kvantdator med supraledande kvantbitar. Den ursprungliga målsättningen formulerades kring en maskin med minst 100 välfungerande kvantbitar. Det bör läsas som ett program- och utvecklingsmål, inte som ett påstående om att en feltolerant dator med 100 logiska kvantbitar redan finns.
Att Chalmers och Google arbetar med samma breda hårdvarufamilj gör Willow-resultatet särskilt relevant. Problemen känns igen: materialförluster, tillverkning, koherenstider, mikrovågskontroll, avläsning och störningar mellan komponenter. Förbättringar i en del av kedjan måste fungera tillsammans med de andra.
En bättre enskild kvantbit är exempelvis inte tillräcklig om tvåkvantbitsoperationerna förblir alltför felbenägna. Snabbare mätning hjälper inte fullt ut om den samtidigt stör grannarna. Och en välfungerande liten krets kan få nya problem när kablar, styrkanaler och kalibreringar blir fler.
Här är en långsiktig forskningsmiljö viktig på ett sätt som sällan syns i presentationen av ett nytt chip. Doktorander och ingenjörer behöver lära sig att tillverka övergångar med jämna egenskaper, analysera brus, programmera styrsystem och förstå algoritmernas krav. Kompetensen finns inte i en enda komponent som kan beställas och monteras in.
För WACQT är det därför inte bara frågan om att nå ett visst antal kvantbitar. Satsningens värde ligger också i förmågan att självständigt bygga, mäta och bedöma en kvantprocessor – och att samarbeta med användare som kan skilja ett vetenskapligt intressant problem från ett där en kvantdator faktiskt kan göra skillnad.
Ett rimligt tillämpningsexempel är kvantkemiska beräkningar. Molekyler följer redan kvantmekanikens lagar, och vissa elektroniska tillstånd blir mycket svåra att beskriva exakt med klassiska metoder. Men även där måste en framtida kvantlösning jämföras med starka klassiska approximationer. Kvantmekanisk natur innebär inte automatiskt att varje kemiskt problem får en praktisk kvantfördel.
Genombrottet är en riktning, inte en färdig maskin
Efter Willow blir nästa prövning att upprepa framgången i större skala och under mer varierade arbetsuppgifter. Fler logiska kvantbitar måste kunna skyddas samtidigt. De behöver växelverka utan att skyddet försvinner. Avkodningen måste vara tillräckligt snabb, och ovanliga, korrelerade fel måste upptäckas och begränsas.
Dessutom måste tillförlitligheten förbättras långt bortom vad som räcker för en kort demonstration. En liten felfrekvens per cykel kan fortfarande vara för hög när en beräkning kräver mycket många cykler och operationer. Varje användning får därför en slags felbudget: sannolikheten att hela beräkningen lyckas måste hållas tillräckligt hög.
Skalningen gäller också sådant som ligger utanför själva chipet. Styrsignaler ska nå fram, mätdata ska transporteras och kylsystemets kapacitet ska räcka. Kalibreringar måste kunna underhållas utan att driftstiden försvinner i felsökning. En framtida kvantdator är ett helt maskinsystem, inte bara en mer tätpackad processor.
Det är därför för tidigt att dra en säker tidslinje från Willow till bred kommersiell nytta. Resultatet visar inte att varje tekniskt hinder har undanröjts. Det visar att en av de mest grundläggande principerna bakom en stor kvantdator fungerar tydligt i en avancerad supraledande processor: extra redundans kan ge bättre skydd i stället för mer sammanlagt fel.
Det förändrar forskningsfrågan. Tidigare handlade mycket om huruvida felkorrigeringen över huvud taget skulle kunna vinna över hårdvarans brister i ett växande system. Nu finns ett starkare experimentellt stöd för att den kan göra det, åtminstone inom den storlek och de förhållanden som har prövats.
Willows viktigaste löfte är därmed mindre spektakulärt än siffran 10²⁵ år, men mer användbart. Kvantdatorn behöver inte bestå av perfekta komponenter. Den behöver bestå av tillräckligt bra komponenter, organiserade så att helheten blir pålitligare när den växer. I december 2024 tog den idén ett tydligt steg från teori och begränsade demonstrationer till mätbar skalning.
Källor
- Google Quantum AI and Collaborators, Quantum error correction below the surface code threshold (2024)
- Hartmut Neven, Google, Meet Willow, our state-of-the-art quantum chip (2024)
- Google Quantum AI, Suppressing quantum errors by scaling a surface code logical qubit (2023)
- Youngseok Kim med flera, Evidence for the utility of quantum computing before fault tolerance (2023)
- Sergey Bravyi med flera, High-threshold and low-overhead fault-tolerant quantum memory (2024)
- Chalmers tekniska högskola, Wallenberg Centre for Quantum Technology
Ställ frågor om "Willow visar vägen mot kvantdatorn som kan rätta sina egna fel". Svaren bygger på tidningens egna artiklar.